Indexação de dados
Cada base vira um índice pesquisável
O DeepMiner importa arquivos CSV, XLSX, JSON (array) e NDJSON, e também registros em JSON pela API. Cada base vira um índice pesquisável com schema: você cola um documento de exemplo, o DeepMiner infere os campos e os tipos, e você marca o campo-chave. Campos de CPF, CNPJ, telefone e e-mail são reconhecidos como sensíveis. A importação mostra o progresso em tempo real e guarda o histórico.
O que você faz
Importe CSV, XLSX, JSON e NDJSON. Cada base vira um índice com schema e tipos.
-
Quatro formatos de arquivo
CSV, XLSX, JSON em array e NDJSON entram pela tela Importar Dados. Escolha o índice, envie o arquivo e acompanhe o total de registros, os processados e os que falharam.
-
Schema a partir de um exemplo
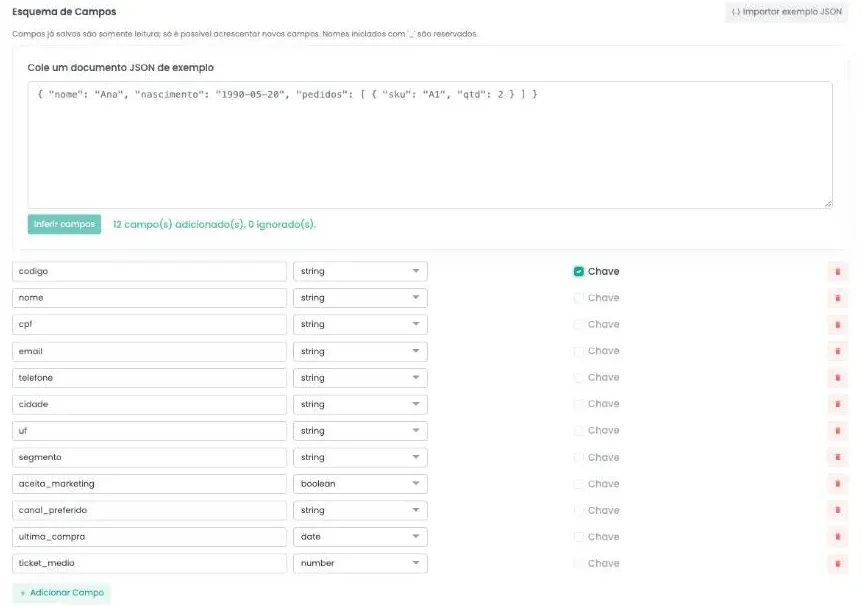
Cole um documento JSON de exemplo e clique em Inferir campos. O DeepMiner cria os campos com tipo texto, número, data, booleano, objeto ou lista, inclusive os aninhados.
-
Campo-chave para reimportar sem duplicar
Marque um campo como chave. Ao importar de novo, o registro com a mesma chave é atualizado em vez de duplicado.
-
Schema que só cresce
Campos já salvos ficam somente leitura e novos campos podem ser acrescentados a qualquer momento. Dashboards, fluxos e consultas antigas continuam funcionando.
-
Sensíveis reconhecidos
Campos com nome de CPF, CNPJ, telefone ou e-mail são marcados como sensíveis. Os valores ficam fora do prompt da IA e das tabelas de dashboard.
Do arquivo ao índice
Crie o índice com um nome e uma descrição e defina o esquema de campos. A forma mais rápida é colar um registro de exemplo em JSON: o DeepMiner lê a estrutura, cria os campos com os tipos e mostra quantos foram adicionados. Objetos e listas de objetos, como pedidos dentro de um cliente, viram campos aninhados.
Depois, em Importar Dados, escolha o índice e envie o arquivo. A barra de progresso atualiza sozinha e mostra o total, os processados, as falhas e o status. O Histórico de Importação guarda cada arquivo com a origem (arquivo ou API) e o relatório de erros.
Bases diferentes, o mesmo jeito de consultar
Uma exportação do CRM em CSV, uma planilha da operação em XLSX e um dump de sistema em NDJSON terminam no mesmo formato: um índice com schema. Daí em diante, as três respondem ao assistente de IA, entram em dashboards e servem de origem para fluxos.
Cada registro importado ganha metadados de controle, como a data de importação e o status. Os nomes iniciados com sublinhado são reservados para esses metadados e para os campos que os provedores devolvem.
Campos sensíveis
Campos com nome de CPF, CNPJ, telefone, celular ou e-mail são reconhecidos como sensíveis. A IA vê só o nome e o tipo desses campos, as tabelas dos dashboards não os exibem e os filtros de fluxo pedem que você digite o valor em vez de listar os valores da base.
Perguntas frequentes
Indexação de dados
Quais formatos posso importar?
CSV, XLSX, JSON (um array de objetos) e NDJSON, um objeto JSON por linha. Pela API, os registros chegam como uma lista em JSON.
Preciso criar o schema campo a campo?
Não. Cole um documento de exemplo e use Inferir campos. Depois ajuste o tipo de cada campo e marque a chave antes de salvar.
O que acontece se eu importar o mesmo arquivo duas vezes?
Se o índice tiver um campo-chave, os registros com a mesma chave são atualizados. Sem campo-chave, cada importação cria registros novos.
Posso remover um campo do schema?
Não. Campos já salvos ficam somente leitura, para não quebrar o que depende deles. Você pode acrescentar campos novos quando quiser.
Como sei se alguma linha falhou?
O progresso mostra os registros processados e os com falha, e o histórico de importação guarda o relatório de erros de cada arquivo.
Veja o DeepMiner trabalhando na sua base.
Agende uma demonstração e acompanhe uma base ser indexada, enriquecida e consultada.