Indexación de datos
Cada base se convierte en un índice consultable
DeepMiner importa archivos CSV, XLSX, JSON (array) y NDJSON, y también registros en JSON por la API. Cada base se convierte en un índice consultable con esquema: pegas un documento de ejemplo, DeepMiner infiere los campos y los tipos, y tú marcas el campo clave. Los campos de CPF, CNPJ, teléfono y correo electrónico se reconocen como sensibles. La importación muestra el progreso en tiempo real y guarda el historial.
Lo que puedes hacer
Importa CSV, XLSX, JSON y NDJSON. Cada base se convierte en un índice con esquema y tipos.
-
Cuatro formatos de archivo
CSV, XLSX, JSON en array y NDJSON entran por la pantalla Importar datos. Elige el índice, sube el archivo y sigue el total de registros, los procesados y los que han fallado.
-
Esquema a partir de un ejemplo
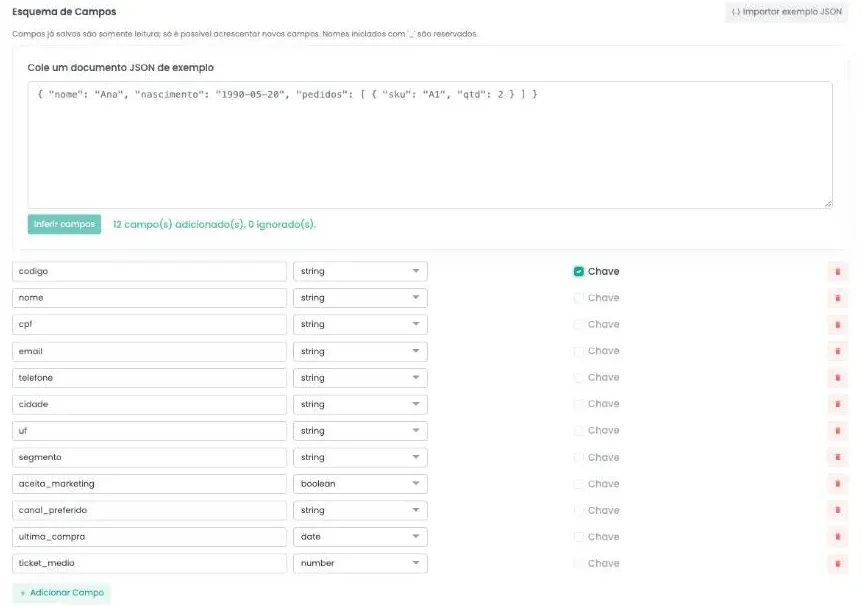
Pega un documento JSON de ejemplo y pulsa Inferir campos. DeepMiner crea los campos con tipo texto, número, fecha, booleano, objeto o lista, incluidos los anidados.
-
Campo clave para reimportar sin duplicar
Marca un campo como clave. Al importar de nuevo, el registro con la misma clave se actualiza en lugar de duplicarse.
-
Esquema que solo crece
Los campos ya guardados pasan a solo lectura y se pueden añadir campos nuevos en cualquier momento. Los dashboards, flujos y consultas anteriores siguen funcionando.
-
Sensibles reconocidos
Los campos con nombre de CPF, CNPJ, teléfono o correo electrónico se marcan como sensibles. Los valores quedan fuera del prompt de la IA y de las tablas de los dashboards.
Del archivo al índice
Crea el índice con un nombre y una descripción y define el esquema de campos. La forma más rápida es pegar un registro de ejemplo en JSON: DeepMiner lee la estructura, crea los campos con sus tipos y muestra cuántos se han añadido. Los objetos y las listas de objetos, como los pedidos dentro de un cliente, pasan a ser campos anidados.
Después, en Importar datos, elige el índice y sube el archivo. La barra de progreso se actualiza sola y muestra el total, los procesados, los fallos y el estado. El Historial de importación guarda cada archivo con su origen (archivo o API) y el informe de errores.
Bases distintas, la misma forma de consultar
Una exportación del CRM en CSV, una hoja de cálculo de la operación en XLSX y un volcado de sistema en NDJSON acaban en el mismo formato: un índice con esquema. A partir de ahí, las tres responden al asistente de IA, entran en dashboards y sirven de origen para los flujos.
Cada registro importado recibe metadatos de control, como la fecha de importación y el estado. Los nombres que empiezan por guion bajo están reservados para esos metadatos y para los campos que devuelven los proveedores.
Campos sensibles
Los campos con nombre de CPF, CNPJ, teléfono, móvil o correo electrónico se reconocen como sensibles. La IA ve solo el nombre y el tipo de esos campos, las tablas de los dashboards no los muestran y los filtros de flujo piden que escribas el valor en lugar de listar los valores de la base.
Preguntas frecuentes
Indexación de datos
¿Qué formatos puedo importar?
CSV, XLSX, JSON (un array de objetos) y NDJSON, un objeto JSON por línea. Por la API, los registros llegan como una lista en JSON.
¿Tengo que crear el esquema campo a campo?
No. Pega un documento de ejemplo y usa Inferir campos. Después ajusta el tipo de cada campo y marca la clave antes de guardar.
¿Qué pasa si importo el mismo archivo dos veces?
Si el índice tiene un campo clave, los registros con la misma clave se actualizan. Sin campo clave, cada importación crea registros nuevos.
¿Puedo quitar un campo del esquema?
No. Los campos ya guardados quedan en solo lectura, para no romper lo que depende de ellos. Puedes añadir campos nuevos cuando quieras.
¿Cómo sé si ha fallado alguna fila?
El progreso muestra los registros procesados y los que han fallado, y el historial de importación guarda el informe de errores de cada archivo.
Mira DeepMiner trabajando sobre tu base.
Solicita una demostración y sigue cómo una base se indexa, se enriquece y se consulta.